L’intelligenza artificiale agentica cambia le esigenze dell’infrastruttura: oltre alla potenza di calcolo, servono memoria, comunicazioni rapide e protezione dei dati durante l’elaborazione. Google affronta la nuova situazione ampliando l’ottava generazione di Tensor Processing Unit con TPU 8tx e TPU 8i Max, due sistemi destinati rispettivamente ai carichi di lavoro riservati e alle applicazioni che devono elaborare grandi quantità di informazioni nei modelli.
Le novità affiancano TPU 8t, dedicata all’addestramento su larga scala, e TPU 8i, progettata per il ragionamento in tempo reale. Google porta così a quattro le configurazioni della stessa generazione presentate in un anno. Secondo quanto riferisce Amin Vahdat, Chief Technologist e Senior Vice President for AI and Infrastructure, il business delle TPU conta ormai quasi cento clienti, tra laboratori di ricerca, società di trading, retailer e università.
TPU 8tx, proteggere dati e modelli durante l’elaborazione
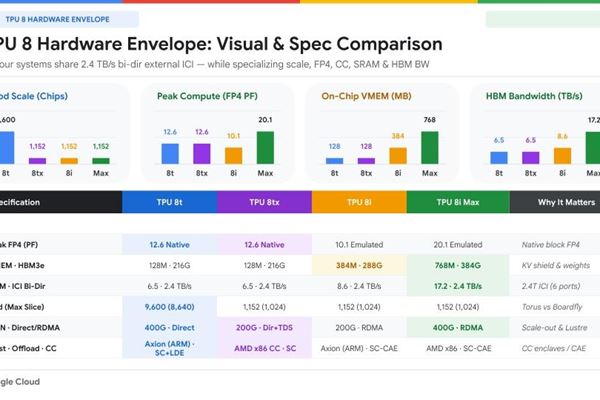
TPU 8tx si rivolge soprattutto alle imprese dei settori regolamentati e alle organizzazioni governative che intendono utilizzare modelli e agenti AI su informazioni sensibili. Il sistema impiega lo stesso silicio di TPU 8t, abbinato a CPU AMD personalizzate, e introduce funzionalità di confidential computing a livello hardware.
L’obiettivo è proteggere e isolare dati e pesi dei modelli anche mentre vengono usati, estendendo la tutela oltre la cifratura delle informazioni archiviate o trasmesse in rete. La configurazione adotta inoltre Boardfly, la rete a bassa latenza sviluppata per il ragionamento in tempo reale. Secondo Google, questa combinazione può dimezzare la latenza rispetto a TPU 8t, con una riduzione delle prestazioni prossima allo zero per le funzionalità di protezione. Oltre all’inferenza, TPU 8tx supporta l’addestramento su scala contenuta. Le aziende possono quindi utilizzare un unico sistema per eseguire e personalizzare i modelli: dal fine-tuning con dati privati alla distillazione di modelli più piccoli, fino all’addestramento degli agenti mediante apprendimento per rinforzo. Il tutto riducendo la necessità di trasferire informazioni sensibili tra cluster distinti.
TPU 8i Max, due chip per affrontare il limite della memoria
TPU 8i Max affronta invece il collo di bottiglia della memoria. Quando più agenti analizzano un’intera base di codice o ore di video, la velocità con cui i dati raggiungono i processori può limitare l’esecuzione. Google ha riunito due chip TPU 8i in un unico package, raddoppiando rispetto a TPU 8i la capacità di calcolo, la memoria SRAM e la banda della memoria HBM. La configurazione punta a sostenere finestre di contesto molto ampie, nell’ordine dei milioni di token, mantenendo i processori alimentati con i dati necessari.
Il raddoppio del silicio a parità di ingombro del rack aumenta anche la densità di calcolo. Per gli operatori dei data center, la proposta riguarda quindi sia le prestazioni dei carichi di lavoro sia lo sfruttamento dello spazio disponibile.
PyTorch e strumenti aperti per favorire l’adozione
All’ampliamento hardware si accompagna un investimento sul software. Con TorchTPU, distribuito come progetto open source, Google punta a consentire l’esecuzione nativa su TPU del codice PyTorch e dei modelli Hugging Face, senza riscritture. L’offerta comprende anche backend TPU per i motori di inferenza vLLM e SGLang. Una suite di agenti per TPU, disponibile in anteprima, si integra con strumenti di sviluppo come Claude Code, Cursor e Google Antigravity. Le funzioni dichiarate comprendono l’avvio dell’ambiente, l’individuazione dei colli di bottiglia e l’ottimizzazione dei kernel attraverso istruzioni in linguaggio naturale.
Per la produzione, il nuovo XLA Serving Engine open source permette di addestrare i modelli in Python e servirli attraverso un runtime C++ a bassa latenza su TPU, GPU e CPU.
Una parte degli aggiornamenti riguarda il comportamento degli agenti, che possono restare in attesa di una risposta da un database, da uno strumento esterno o da una persona. Il nuovo Agent Compute Engine sospende automaticamente le sessioni inattive e sposta la memoria di lavoro fuori dal chip in tempi misurabili in millisecondi. Google annuncia inoltre il rilascio open source di TPU Sync, un livello software che coordina memoria HBM degli acceleratori, DRAM degli host, storage condiviso e rete. Il sistema gestisce lo spostamento delle cache usate dai modelli e la sincronizzazione dei pesi nei processi di apprendimento per rinforzo. L’azienda dichiara riduzioni superiori al 90% nella latenza di trasferimento delle cache KV e nel tempo necessario a generare il primo token.
Sul fronte dell’orchestrazione, arriva la disponibilità su Google Kubernetes Engine di Cloud Pathways che consente di gestire sistemi TPU distribuiti attraverso un unico controller. Anche l’accesso a GKE dynamic slicing è stato esteso a tutti i clienti e permette di riunire o suddividere dinamicamente le risorse TPU tramite commutazione ottica. Secondo i dati diffusi da Google, questa flessibilità può rendere l’avvio dei task fino a cinque volte più veloce e accelerare il recupero dai guasti fino a 4,5 volte.